DeepSeek publica como código abierto el motor de inferencia DeepInfer
El motor es abierto, pero los componentes de caché y balanceo de carga que sustentan las cifras reportadas no se publicaron por completo.
155Ttokens por día de un solo clúster
En corto
- DeepSeek publicó como código abierto DeepInfer, el framework de inferencia detrás de DeepSeek-V4.1-Flash, el día 1 de PyTorch Conf.
- DeepInfer es una personalización de vLLM que da crédito a SGLang y TRTLLM, y deja fuera el caché KV, la desagregación PD y el balanceo de carga de DeepSeek.
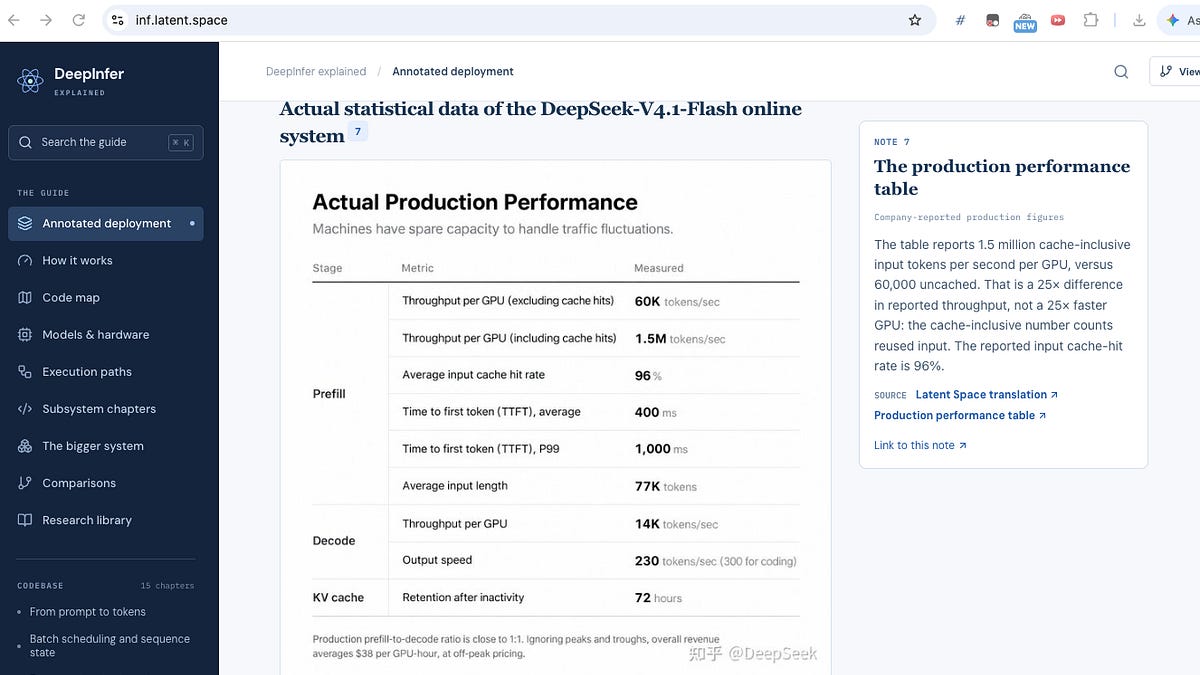
- DeepSeek reporta 155 billones de tokens por día desde un solo clúster, una tasa de aciertos de caché de entrada del 96% y $38 de ingreso por acelerador por hora a precios fuera de hora pico.
- Estas cifras son afirmaciones de producción de la propia empresa y no han sido auditadas de forma independiente. El equipo de vLLM reportó un rendimiento de decodificación dentro del 6% de los resultados publicados por DeepInfer en GB200, con una configuración equivalente.
Por qué importa
La publicación muestra cómo el caché y la programación de tareas determinan el costo de servir modelos abiertos a gran escala, algo que importa a los desarrolladores que ejecutan inferencia. Reproducir las cifras de DeepSeek no es sencillo, porque la orquestación a nivel de servicio sigue siendo responsabilidad de quien despliega.
“Introducing DeepInfer, our in-house inference framework, now fully open source!”
Qué dice la gente
Los comentaristas en Hacker News preguntaron por qué DeepSeek publicó el trabajo y si la decisión fue estratégica. Un comentarista comparó la cifra de $38 con precios de alquiler de unos $2.75 por hora de H100 y señaló que DeepSeek no indica el modelo de tarjeta. Otro señaló que la publicación no incluye el sistema de caché KV.